字符串与搜索
C.归并排序
题意:对两个无序且长度任意的序列a和b进行归并,同时要求结果的字典序最小
分析:其实就是每次取剩余序列中字典序更小的那一侧的点。
- 当时,取小的那个;
- 当时,这两个点分别向后找,把与这两个点值一样的都去掉(一直找到值不一样的两个点),然后输出较小的那个即可。
然而如果直接这样去一个一个找的话,在遇到类似这样的序列时,每次都要扫一遍序列,复杂度很高,需要优化。
优化:对于连续相同的一系列数,我们让它们都指向这一系列数的末尾,这样每次向后查询与当前数字不同的数字时可以一步到位,直接跳到该系列数的最后一个。
int n, m;
int a[N], b[N], c[2 * N];
int a_dex[N], b_dex[N];
int cnt, ai = 1, bi = 1, aai = 1, bbi = 1;
void solve() {
	memset(a, 63, sizeof(a)) ,memset(b, 63, sizeof(b));
	memset(a_dex, 63, sizeof(a_dex)), memset(b_dex, 63, sizeof(b_dex));
	si(n); for (int i = 1; i <= n; i++)si(a[i]);
	si(m); for (int i = 1; i <= m; i++)si(b[i]);
	for (int i = n; i >= 1; i--) a_dex[i] = a[i] == a[i + 1] ? a_dex[i + 1] : i;
	for (int i = m; i >= 1; i--) b_dex[i] = b[i] == b[i + 1] ? b_dex[i + 1] : i;
	while (cnt < n + m) {
		if (a[ai] > b[bi])
			c[++cnt] = b[bi++];
		else if (a[ai] < b[bi])
			c[++cnt] = a[ai++];
		else {
				aai = ai, bbi = bi;
				if (ai == n)
					c[++cnt] = b[bi++];
				else if (bi == m)
					c[++cnt] = a[ai++];
				else {
					while (1) {
						aai = a_dex[aai] + 1, bbi = b_dex[bbi] + 1;
						if ((aai - ai) != (bbi - bi)) {
							c[++cnt] = (aai - ai) < (bbi - bi) ? a[ai++] : b[bi++];
							break;
						}
						else if (a[aai] != b[bbi]) {
							c[++cnt] = a[aai] < b[bbi] ? a[ai++] : b[bi++];
							break;
						}
						if (aai > n) { c[++cnt] = b[bi++]; break;}
						if (bbi > m) {c[++cnt] = a[ai++]; break;}
					}
				}

		}
	}
	for (int i = 1; i <= n + m; i++)printf("%d ", c[i]);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
G. 进化
题意:起始有得分,每次可以选一个数字使得分加上,这个时通过上次选的数字通过复杂公式得到两个数字,求几轮后可以让得分大于等于300
分析:每次得分最多加6,也就是说至少要扫50层,直接会,于是考虑使用可行性剪枝+迭代加深。
可行性剪枝:这个剪枝相当重要。首先我们有一个最大搜索深度,在当前深度,如果剩余的搜索里每次都加6还达不到300的话就退出,搜到之后更新一下最大搜索深度即可。
迭代加深:每次设定一个搜索深度上限,搜索深度大于设定值(还没搜到)时就退出,然后增加搜索深度上限重新搜索。这种做法的有点是:有类似的处理效果,但又有的空间复杂度。
然而我最初写的迭代加深+可行性剪枝会在39到41的点,后来更改为每次迭代加深+2,找到后往回扫一次取最小值。这样每次跳两步的迭代加深比每次跳一步的快一点点就过了。就嗯卡过去
#include <bits/stdc++.h>
template<typename T>
inline void read(T& x) { x = 0; char c = getchar(); while (!isdigit(c))c = getchar(); while (isdigit(c)) { x = x * 10 + c - '0'; c = getchar(); } }
#define si(a) read(a)
#define sii(a,b) read(a),read(b)
#define siii(a,b,c) read(a),read(b),read(c)
#define fl float
#define ll long long int
#define ull unsigned long long int
using namespace std;
int gcd(int a, int b) { return a == 0 ? b : gcd(b % a, a); }
//const ll MOD = 924844033;
const int N = 2e6 + 10;
int n, m, S;
int flag = 1, now, ans = 114514;
ll seed, MOD = 1LL << 32;
ll A1(ll A0) { return (213346089LL * A0 + 870413LL) % MOD; }
ll A2(ll A0) { return (166042049LL * A0 + 598777LL) % MOD; }
void dfs(int u, int lim, int sum, ll food) {
	if (!flag || u>lim) return;
	ll a1 = A1(food), a2 = A2(food);
	if (sum >= S) {
		flag = 0, ans = min(ans,u);
		return;
	}
	if (sum + 6 * (lim - u) < S)
		return;
	dfs(u + 1, lim, sum +a1 % 7, a1);
	dfs(u + 1, lim, sum + a2 % 7, a2);
}
void solve() {
	sii(seed, S);
	now = -1;
	while (flag) {
		now += 2;
		dfs(1, now, seed % 7, seed);
	}
	flag = 1;
	dfs(1, now-1, seed % 7, seed);
	printf("%d", ans);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
		solve();
	return 0;
}
/*

*/
H. 回文串
题意:对于一个串 s,定义 s 的某个子串的权值为其在原串的出现次数乘以该子串的长度。给定串 s, 求其所有回文子串的最大权值。
分析: 回文自动机,同时记录回文串的出现次数
回文自动机/回文树
结构:像AC自动机一样,我们有一个fail指针用来跳字符树。有两个字符树,0表示回文串长度为偶数的树,1表示回文串长度为奇数的树。每个节点虽然只有一个字符,其表示的其实是一个回文串,比如:0→a→b,a节点表示回文串aa,b表示回文串abba。对于每个节点,它的fail指针指向这个节点表示的回文串的后缀中最长的回文串。特殊的有:0节点fail指针指向1,其他非1、0节点若后缀无回文串指向0,1节点的fail指针不用考虑。
操作:每次读入一个字符,从上次的后缀回文(用last存一下)跳fail指针直到能构成回文,更新回文树,再对这个节点跳fail指针获得它的fail指针。
跳fail指针:
int getfail(int x, int now) { while (s[now - len[x] - 1] != s[now])x = fail[x]; return x; }//x是当前fail指针指向的,now是当前处理的节点;返回最长后缀回文
搭建当前节点的fail指针:
fail[q] = tr[getfail(fail[p], i)][s[i]];//tr[][]为回文树
同时,对于该题我们还需要统计一下回文串的出现次数,这里可以直接在每次处理的回文串对应处cnt++,但这样有个小问题,长的回文串可能会包含小的回文串,而此时小的回文串并没有考虑到长的回文串的计数。所以在最后count的时候逆序累加,让每个父节点(小回文串)都能加上所有后代(大回文串),同时更新ans。
for (int i = tot; i > 0; i--) {//tot是回文树的节点数
		cnt[fail[i]] += cnt[i];
		ans = max(ans, cnt[i] * len[i]);
	}
#include <bits/stdc++.h>
template<typename T>
inline void read(T& x) { x = 0; char c = getchar(); while (!isdigit(c))c = getchar(); while (isdigit(c)) { x = x * 10 + c - '0'; c = getchar(); } }
#define si(a) read(a)
#define sii(a,b) read(a),read(b)
#define siii(a,b,c) read(a),read(b),read(c)
#define fl float
#define ll long long int
#define ull unsigned long long int
using namespace std;
int gcd(int a, int b) { return a == 0 ? b : gcd(b % a, a); }
//const ll MOD = 924844033;
const int N = 2e6 + 10;
int n, m;
ll ans = 0;
char s_[N];
int p, q, pp = 0;
int s[N];
int cnt[N], len[N], tot = 1, tr[N][26], fail[N];
int getfail(int x, int now) { while (s[now - len[x] - 1] != s[now])x = fail[x]; return x; }//返回最长后缀回文
void start() {//初始化
	for (int i = 1; s_[i]; i++)s[i] = s_[i] - 'a';
	s[0] = -1;
	len[0] = 0, len[1] = -1;
	fail[0] = 1;
}
void solve() {
	scanf("%s", s_+1);
	start();
	int s_len = strlen(s_ + 1);
	for (int i = 1; i<=s_len; i++) {
		p = getfail(pp, i);//从上一次的后缀回文开始找能回文的地方
		if (!tr[p][s[i]]) {
			len[++tot] = len[p] + 2, q = tot;
			fail[q] = tr[getfail(fail[p], i)][s[i]];//搭fail
			tr[p][s[i]] = q;
		}
		pp = tr[p][s[i]];
		cnt[pp]++;
	}
	for (int i = tot; i > 0; i--) {
		cnt[fail[i]] += cnt[i];//逆序累加,所以每个父节点都能加上所有的后代
		ans = max(ans, (ll)(cnt[i]) * (ll)(len[i]));
	}
	printf("%lld\n", ans);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
		solve();
	return 0;
}
/*

*/
Q. 接头暗号
题意: 给定一个文本t和一个字符串s,求t中s的出现次数。
KMP
首先要了解前缀函数:给定一个长度为的字符串 ,其前缀函数被定义为一个长度为的数组。其中是子串最长的相等的真前缀与真后缀的长度。
那么,计算π[i]的朴素算法显然就是不停的扫,时间复杂度为。可以发现,每次读入一个字符时,如果,那么就有(数组从0开始),也就是说,会出现下面的情况:
图来自OI Wiki
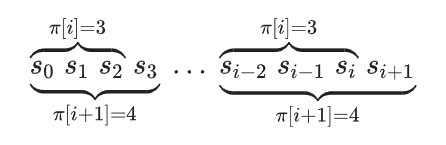
那如果如何去找呢?我们还会发现,对于子串,首先有,然后就会发现,这两个小子串完全一致就会导致前面那个小子串的前缀性质会保留到后一个小子串,也就是又会有一个前缀和的后缀相等,而这个前缀/后缀的长度显然就是,就是下面图所示:
图还是来自OI Wiki
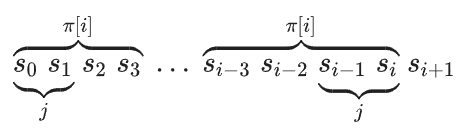
所以在失配的时候就可以不停的跳π[i]来找相等的前缀,时间复杂度为
回到,将字符串和文本拼接起来,中间用一个两者都没有的字符(如'#')隔开,然后跑前缀函数即可。
#include <bits/stdc++.h>
template<typename T>
inline void read(T& x) { x = 0; char c = getchar(); while (!isdigit(c))c = getchar(); while (isdigit(c)) { x = x * 10 + c - '0'; c = getchar(); } }
#define si(a) read(a)
#define sii(a,b) read(a),read(b)
#define siii(a,b,c) read(a),read(b),read(c)
#define fl float
#define ll long long int
#define ull unsigned long long int
using namespace std;
int gcd(int a, int b) { return a == 0 ? b : gcd(b % a, a); }
//const ll MOD = 924844033;
const int N = 5e5 + 10;
int n, m;
char s[5000000];
char t[5000010];
int ans;
int pi[5000010];
void solve() {
	scanf("%s", s);
	scanf("%s", t);
	int cao = strlen(t);
	t[cao] = '#';
	strcat(t, s);
	int len = strlen(t);
	for (int x = 1; x < len; x++) {
		int y = pi[x - 1];
		while (y > 0 && t[x] != t[y])
			y = pi[y - 1];
		if (t[x] == t[y])
			y++;
		pi[x] = y;
		if (pi[x] == cao)
			ans++;
	}
	printf("%d", ans);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
/*
3
what
is
mind
thisisnotmind
*/
R. 国际象棋
题意:5×5的棋盘,有12个黑子、12个白子和一个空格,每个子的移动方式为国际象棋中马的走法,要求最后棋局长这样:
11111
01111
00*11
00001
00000
1是黑子,0是白子,*是空格。求最小步数(步数大于15输出-1)
迭代加深+可行性剪枝
- 由于最大步数就是15,直接设搜索深度为15即可。
- 移动一次会改变两个子的位置,移动两次最多改变三个子的位置,移动n次最多改变n+1个子的位置,我们需要记录并计算当前棋局与终局棋子的差异个数,如果差异次数大于剩余次数+1,那就是不可能在剩余步数里下完棋局,就可以直接退出了。
- 每次枚举空格周围的8个格子而不是枚举每个棋子。
const int N = 2e6 + 10;
int n, m;
int ans;
int next_x[9] = { 0,-2,-1,1,2,2,1,-1,-2 };
int next_y[9] = { 0,1,2,2,1,-1,-2,-2,-1 };
char chess[6][6];
char chess_end[6][6] = {
	{'1','1','4','5','1','4'},
	{'w','1','1','1','1','1'},
	{'c','0','1','1','1','1'},
	{'w','0','0','*','1','1'},
	{'c','0','0','0','0','1'},
	{'A','0','0','0','0','0'}
};
bool check_xy(int a, int b, int th) {
	if ((a + next_x[th] >= 1) && (b + next_y[th] >= 1) && (a + next_x[th] <= 5) && (b + next_y[th] <= 5))
		return true;
	return false;
}
bool ok_() {
	for (int i = 1; i <= 5; i++)
		for (int j = 1; j <= 5; j++)
			if (chess_end[i][j] != chess[i][j])
				return false;
	return true;
}
int diff() {
	int cnt = 0;
	for (int i = 1; i <= 5; i++)
		for (int j = 1; j <= 5; j++)
			if (chess_end[i][j] != chess[i][j])
				cnt++;
	return cnt;
}
void dfs(int u, int x,int y, int now) {
	if (u > 15 || u>=ans)
		return;
	if (!now) {
		ans = min(ans, u);
		return;
	}
	if (now > 16 - u) return;
	for (int i = 1; i <= 8; i++)
		if (check_xy(x, y, i)) {
			int tmp = 0;
			int x2 = x + next_x[i], y2 = y + next_y[i];
			if (chess[x][y] == chess_end[x][y]) tmp++;
			if (chess[x2][y2] == chess_end[x2][y2]) tmp++;
			if (chess[x][y] == chess_end[x2][y2])tmp--;
			if (chess[x2][y2] == chess_end[x][y]) tmp--;
			swap(chess[x][y], chess[x + next_x[i]][y + next_y[i]]);
			dfs(u + 1, x + next_x[i], y + next_y[i],now+tmp);
			swap(chess[x][y], chess[x + next_x[i]][y + next_y[i]]);
		}
}
void solve() {
	ans = 114514;
	for (int i = 1; i <= 5; i++)
		scanf("%s", chess[i]+1);
	getchar();
	int tmp = diff();
	for (int i = 1; i <= 5; i++)
		for (int j = 1; j <= 5; j++)
			if (chess[i][j] == '*') {
				dfs(0, i, j, tmp);
				if (ans >15) printf("-1\n");
				else printf("%d\n", ans);
				return;
			}
}
int main() {
	int t;
	si(t);
	while (t--)
		solve();
	return 0;
}
/*
2
1*111
01111
00111
00001
00000
01011
110*1
01110
01010
00100
*/
S. 井字棋
题意:普普通通井字棋,规定井字棋终局的得分为相同子连成一条线的个数,有个井字棋的棋局,指定下一步是谁下的,玩家想让终局分数最大,玩家想让其最小,下'',下'',两人每一步都是最优的,求个井字棋棋局的最终得分
究极打表
考虑到最终棋局的状态只有种,这个数字相当之小,如果我们能把每个残局都直接指向其终局,那么个棋局直接查询就能得到答案。
棋局的储存
采用一个18位二进制来保存一个棋局,每两位表示一个格子的状态:00为空,01为'',10为''
记忆化搜索
- 遍历棋盘9个格子的3种状态('X','O',空),如果当前棋局没有遍历过就继续(记忆化保证不重复搜索)
- 设为在棋局i下a先手的最终得分,同理;设为在棋局上(某一点)下''的最终得分,同理,那么的取值即为,即取下完''后的棋局里的得分,因为下子后是走,的取值同理为。为什么能直接取和,因为和的操作是在当层之后的,也就是更新操作是从终局向空棋盘进行更新的
int n, m;
/*
01-->gp    10-->na
	 0   1   2
	 3   4   5
	 6   7   8
*/
char chess[9];
ll gp_nxt[9], na_nxt[9];
map<ll, int>ans;
map<ll, int>vis;
map<ll, int>ans_gp;
map<ll, int>gp_vis;
map<ll, int>ans_na;
map<ll, int>na_vis;
bool if_exist(ll x, int dex) { return x & (3 << (2 * dex)); }
int score() {//计算分数
	int sum = 0;
	if (chess[0] == 'O' && chess[1] == 'O' && chess[2] == 'O') sum++;
	if (chess[3] == 'O' && chess[4] == 'O' && chess[5] == 'O') sum++;
	if (chess[6] == 'O' && chess[7] == 'O' && chess[8] == 'O') sum++;
	if (chess[0] == 'O' && chess[3] == 'O' && chess[6] == 'O') sum++;
	if (chess[1] == 'O' && chess[4] == 'O' && chess[7] == 'O') sum++;
	if (chess[2] == 'O' && chess[5] == 'O' && chess[8] == 'O') sum++;
	if (chess[0] == 'O' && chess[4] == 'O' && chess[8] == 'O') sum++;
	if (chess[2] == 'O' && chess[4] == 'O' && chess[6] == 'O') sum++;
	if (chess[0] == 'X' && chess[1] == 'X' && chess[2] == 'X') sum--;
	if (chess[3] == 'X' && chess[4] == 'X' && chess[5] == 'X') sum--;
	if (chess[6] == 'X' && chess[7] == 'X' && chess[8] == 'X') sum--;
	if (chess[0] == 'X' && chess[3] == 'X' && chess[6] == 'X') sum--;
	if (chess[1] == 'X' && chess[4] == 'X' && chess[7] == 'X') sum--;
	if (chess[2] == 'X' && chess[5] == 'X' && chess[8] == 'X') sum--;
	if (chess[0] == 'X' && chess[4] == 'X' && chess[8] == 'X') sum--;
	if (chess[2] == 'X' && chess[4] == 'X' && chess[6] == 'X') sum--;
	return sum;
}
void trs(ll x) {//转化为棋盘
	for (int i = 0; i < 9; i++) {
		int tmp = x & 3;
		if (tmp == 1) chess[i] = 'O';
		else if (tmp == 2) chess[i] = 'X';
		else if (tmp == 0) chess[i] = '.';
		tmp >>= 2;
	}
}
ll trs_x() {//转化为数字(状态)
	ll num = 0LL, tmp;
	for (int i = 8; i >= 0; i--) {
		if (chess[i] == 'O') tmp = 1LL;
		else if (chess[i] == 'X') tmp = 2LL;
		else if (chess[i] == '.') tmp = 0LL;
		num = (num << 2) | tmp;
	}
	return num;
}
void dfs(ll now) {
	ll tmp, tmp2;
	int flag = 1;
	for (int p = 0; p < 9; p++) {
		if (if_exist(now, p))
			continue;//p位置是否有数字
		flag = 0;
		tmp = now | gp_nxt[p];
		tmp2 = now | na_nxt[p];
		if (!vis[tmp])
			chess[p] = 'O', vis[tmp]++, dfs(tmp);
		chess[p] = '.';
		if (!vis[tmp2])
			chess[p] = 'X', vis[tmp2]++, dfs(tmp2);
		chess[p] = '.';
		if (!gp_vis[now]) ans_gp[now] = ans_na[tmp], gp_vis[now]++;
		//else ans_gp[now] = max(ans_gp[now], ans[tmp]);
		if (!na_vis[now]) ans_na[now] = ans_gp[tmp2], na_vis[now]++;
		//else ans_na[now] = min(ans_na[now], ans[tmp2]);
		ans_gp[now] = max(ans_gp[now], ans_na[tmp]);
		ans_na[now] = min(ans_na[now], ans_gp[tmp2]);
	}
	if (flag) ans_na[now] = score(), ans_gp[now] = ans_na[now];
}
void yuchuli() {
	gp_nxt[0] = 1LL, na_nxt[0] = 2LL;
	for (int i = 1; i < 9; i++)
		gp_nxt[i] = gp_nxt[i - 1] << 2, na_nxt[i] = na_nxt[i - 1] << 2;
	dfs(0LL);
}
void solve() {
	int type; si(type);
	for (int i = 1, cnt = 0; i <= 3; i++) {
		char cao[4];
		scanf("%s", cao);
		chess[cnt++] = cao[0];
		chess[cnt++] = cao[1];
		chess[cnt++] = cao[2];
	}
	if (type)
		printf("%d\n", ans_gp[trs_x()]);
	else
		printf("%d\n", ans_na[trs_x()]);
}
int main() {
	int t;
	yuchuli();
	si(t);
	while (t--)
		solve();
	return 0;
}
/*
2
1
.XX
O.X
XOX
0
OOO
OOO
OOO
*/
V. 生日蛋糕
题意:体积n× π的m层蛋糕, 每层都是圆柱体,在下面的蛋糕的半径和高度(都是整数)都要大于在上面的蛋糕,蛋糕的表面积Q=S× π ,对于给定的n和m求蛋糕的最小S(无解输出0)
搜索剪枝:考虑到蛋糕的半径和高度都是整数,也就是说m层蛋糕的最小体积是可以计算得到的。dfs扫所有可行的半径和高度,其中半径和高度的max取上一层的半径和高度减一,最小值为m减当前层数+1。
对于剪枝,如果当前的体积加上剩余层数的最小值已经大于n了,说明体积n× π 的蛋糕做不出就退出。每次搜到一个结果就更新ans,如果当前面积加剩余层数的最小面积大于ans就退出。
const int N = 2e6 + 10;
//int n, m;
int n, m;
int ans=114514;
int rest[10010];
void REST() { for (int i = m, j=0; i >= 1; i--) rest[++j] = i * i * (i + 1) * (i + 1) / 4; }
void dfs(int u, int s_pre, int v_pre, int r_last, int h_last, int s_ground) {
	int r_max = r_last-1, h_max=h_last-1;
	int r_min = 1 + m - u, h_min = r_min;
	if (u == m) {
		if (r_last == 1 || h_last == 1)
			return;
		for (int i = r_max, v = n - v_pre; i >= r_min; i--)
			for (int j = h_max; j >= h_min; j--)
				if (i * i * j == v)
					ans = m == 1 ? min(ans, i * i + s_pre + 2 * i * j) : min(ans, s_ground + s_pre + 2 * i * j);
		return;
	}
	for(int i = r_max;i>=r_min;i--)
		for (int j = h_max; j >= h_min; j--) {
			if (i * i * j + rest[u + 1] + v_pre > n) continue;
			if (u == 1) {
				if (i * i + s_pre + 2 * ((n - v_pre) / r_max) >= ans) continue;
			}
			else if(s_ground+s_pre + 2 * ((n - v_pre) / r_max) >= ans)
				continue;
			if (u == 1) s_ground = i * i;
			dfs(u + 1, s_pre + 2 * i * j, v_pre + i * i * j, i,j, s_ground);
		}
}
void solve() {
	sii(n, m);
	REST();
	if (rest[1] > n)
		printf("%d", 0);
	else {
		dfs(1, 0, 0, sqrt(n)+10000, sqrt(n)+10000, 114514);
		if (ans == 114514)
			printf("%d", 0);
		else
			printf("%d", ans);
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
		solve();
	return 0;
}
/*

*/
W. 樱之刻
题意:先给出个字符串,最后给出文本,求每个在中的出现次数
AC自动机
-
对个字符串建字典树,表示节点后加一个字符的节点,—→。同时还要记录一下第个字符串的末尾还是最近哪一次出现过的字符串的末尾(如果有的话,储存),再记录一下节点u是否是某模式串末尾(储存)
-
建树. 对状态,它的指针指向的最长后缀
操作:
-
初始化:遍历个字母,如果存在,向队列中添加;
-
扫队列:设为当前处理节点,如果存在,,同时把塞到队列里。然后. 这样做确实是改变了字典树的结构,但事实上我们在跳指针时只关心能不能匹配到一个串的后缀,所以直接改变了到不会影响指针的匹配,还能起到压缩跳指针路径的作用;
while (l<=r) {//数组模拟队列 int u = q[l++]; for (int i = 0; i < 26; i++) { if (tri[u][i]) { fail[tri[u][i]] = tri[fail[u]][i]; q[++r]=tri[u][i]; continue; } tri[u][i]= tri[fail[u]][i]; } }-
统计出现次数
首先一层扫文本串,初始化得到一个不完整的数组:
for (int i = 0, u = 0; i < len; i++) u = tri[u][s[i] - 'a'], sum[u]++;然后就体会到建树时用数组模拟队列的优点了,逆序队列就是处理树上差分的顺序,此时利用前面保存的数组和数组就能对树上的每个节点,快速遍历以该节点为末尾的所有模式串(这个过程更新数组)。逆序遍历字典树能保证父节点统计到所有后代的值,类似前面回文自动机的处理。
-
const int N = 2e6 + 10;
int n, m;
int cnt, ans_id, l = 1, r;
int ans[N], fail[N], sum[N], id[N],NEXT[N];
int tri[N][27];
char tmp[N];
int q[N];
void get_fail() {
	for (int i = 0; i < 26; i++)
		if (tri[0][i])q[++r]=(tri[0][i]);
	while (l<=r) {
		int u = q[l++];
		for (int i = 0; i < 26; i++) {
			if (tri[u][i]) {
				fail[tri[u][i]] = tri[fail[u]][i];
				q[++r]=tri[u][i];
				continue;
			}
			tri[u][i]= tri[fail[u]][i];
		}
	}
}
void match(char s[]) {
	int u = 0, len = strlen(s);
	for (int i = 0; i < len; i++)
		u = tri[u][s[i] - 'a'], sum[u]++;
	for (int i = cnt; i >= 1; i--) {
		for (int j = id[q[i]]; j; j = NEXT[j])
			ans[j] = sum[q[i]];
		sum[fail[q[i]]] += sum[q[i]];
	}
}
void build(char s[]) {//建字典树
	int len = strlen(s), u = 0;
	for (int i = 0; i < len; i++) {//遍历字符串
		int c = s[i] - 'a';
		if (!tri[u][c])
			tri[u][c] = ++cnt;//没找到
		u = tri[u][c];
	}
	ans_id++;
	NEXT[ans_id] = id[u];
	id[u] = ans_id;
}
void solve() {
	si(n);
	for (int i = 1; i <= n; i++) {
		scanf("%s", tmp);
		build(tmp);
	}
	get_fail();
	scanf("%s", tmp);
	match(tmp);
	for (int i = 1; i <= n; i++)printf("%d\n", ans[i]);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
/*
3
what
is
mind
thisisnotmind
*/
X. APM
题意:给定一个字符串,取其一个前缀和一个后缀(都可以为空且不能重合),要求拼接后的字符串为回文串,求这个拼接字符串的最长长度
分析:对于这个拼接出来的字符串,可以分解成两部分:原字符串长度相等的前后缀+拼接字符串的剩余部分
所以先一一对原字符串匹配前后缀,然后对中间部分跑,取前端或后端遇到边界的回文子串的最大长度,加上之前匹配得到的前后缀长度即为答案。
Manacher
首先考虑将回文串分成奇偶长度两种情况,设是以为中心的最长回文长度的半径长度且长度为奇数,为偶数,先考虑奇数情况:我们记录已找到的子回文串中右边界最大的那个串的左右边界、,那么当我们处理到时,有下面三种情况:
- 若,我们暴力寻找该位置的,并更新、
- 若,在和范围足够大的情况下,会出现下面的情况:
图来自OI Wiki
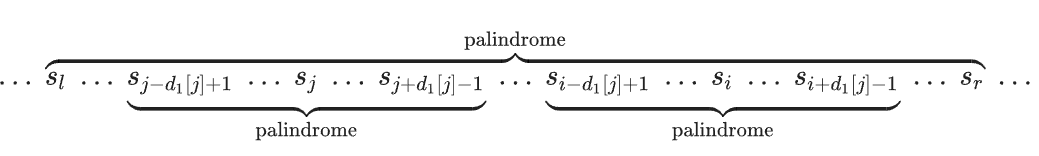
即以为中心的回文子串一定会和以为中心的回文子串完全一致,而这个是可以直接计算得到的,此时
- 在的基础上,如果以为中心的串太大了,超出边界、,可以先取作的值,然后从处暴力匹配更新
的处理同理
最后可以把奇偶情况统一起来:对字符串,比如,我们将其插入分隔符#变成,然后正常跑之前的奇数情况,此时的为在s中以对应位置为中心的回文串的长度加一。
const int N = 2e7 + 10;
int n, m;
int ans = 0, l_, r_;
char s[N];
char s_[N];
int d1[N], d2[N];
void Manacher() {
	s_[0] = '#';
	int cnt = 1;
	for (int i = l_; i <= r_; i++)
		s_[cnt++] = s[i], s_[cnt++] = '#';
	for (int i = 0, l = 0, r = -1; i < cnt; i++) {//奇数,j取l+r-i
		int j = l + r - i;
		int k = (i > r) ? 1 : min(r - i + 1, d1[j]);
		while (i - k >= 0 && i + k < cnt && s_[i - k] == s_[i + k]) k++;
		d1[i] = k--;
		if (i - k == 0 || i + k == cnt-1)
			ans = max(ans, d1[i] - 1);//左右端取到底了
		if (i + k > r)
			l = i - k, r = i + k;
	}
}
void solve() {
	scanf("%s", s);
	int len = strlen(s);
	l_ = 0, r_ = len - 1;
	while (l_< r_)
		if (s[l_] == s[r_])
			l_++, r_--;
		else break;
	if (l_ >= r_)
		printf("%d", len);
	else {
		Manacher();
		printf("%d", ans+l_*2);
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
		solve();
	return 0;
}
/*

*/