Data Structures
A. 猫为什么讨厌狗是有理由的
题意:有个罐子,每个罐子有坚固度,同时有个钥匙,每个钥匙型号为,可以打开坚固度恰好为的罐子。我们可以不断攻击罐子,每次攻击让罐子的坚固度变为(向下取整)。次询问,每次询问到区间,在满足用钥匙开罐子最多的情况下,使用钥匙的最少数。
对于一个钥匙,如果另一个钥匙能通过除以一定次数的变成,则说明能开的都能开(直接锤罐子),也就是说完全没有存在的必要性,直接丢了就行。此时预留下来的钥匙都是独一无二的,无法互相代替,即此时每个罐子至多对应一个钥匙。为每个罐子(二分查找)匹配合适的钥匙(或找不到),那么询问就可以转化为询问到区间的罐子对应了多少互不相同的钥匙。
解决区间内互不相同的数的数量,可以采用前缀和或st表来实现:
前缀和
-
对于每一个型号的钥匙,求得它在1到n区间出现次数的前缀和
for (auto it : key) { cut++; for (int i = 1; i <= n; i++) { if (a[i] == it)//a[i]是罐子 times[cut][i]++; times[cut][i] += times[cut][i - 1]; } } -
那么对于到区间的出现次数即为,只要出现次数不为,就加
ST表:
-
考虑到钥匙数量不超过60个,可以将每个钥匙对应二进制上的一位,则询问就是问到上的钥匙按位或得到的二进制数有多少个1
int n, m, Q;
ull d;
int cut;//key数量
ull a[N], b[N];
ull key_min;
set<ull> key;
int times[64][N];
int qur(int l, int r) {
	int an = 0;
	for (int i = 1; i <= cut; i++)
		if (times[i][r] - times[i][l - 1])
			an++;
	return an;
}
void keydeal() {//去除重复钥匙
	for (int i = 1; i <= m; i++)
		for (int j = i + 1; j <= m; j++)
			if (b[j] != -1 && b[j] != b[i]) {
				ull tem = b[j];
				while ((tem /= d) >= b[i])
					if (tem == b[i]) {
						b[j] = -1;
						break;
					}
			}
	for (int i = 1; i <= m; i++)
		if (b[i] != -1) key.emplace(b[i]);
}
void solve() {
	sii(n, m); sii(d, Q);
	for (int i = 1; i <= n; i++)si(a[i]);
	for (int i = 1; i <= m; i++)si(b[i]);
	sort(b + 1, b + m + 1); key_min = b[1];
	keydeal();
	auto it = key.begin();
	for (int i = 1; i <= n; i++) {
		while (a[i] >= key_min)
			if ((it = key.find(a[i])) != key.end())
				break;
			else
				a[i] /= d;
		if (a[i] < key_min)
			a[i] = -1;
	}
	for (auto it : key) {
		cut++;
		for (int i = 1; i <= n; i++) {
			if (a[i] == it)
				times[cut][i]++;
			times[cut][i] += times[cut][i - 1];
		}
	}
	while (Q--) {
		int l, r; sii(l, r);
		printf("%d\n", qur(l, r));
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
B. 啊哈哈哈,这收集糖果多是一件美事啊
题意:维护一个数据结构,支持区间修改和区间查询
线段树(lazy标记)
OI wiki:线段树可以O(logN) 的时间复杂度内实现单点修改、区间修改、区间查询(区间求和,求区间最大值,求区间最小值)等操作。
线段树的基本结构:
使用线段树来储存数组 时,线段树的一个节点存储的是 上一区间的信息。将数组 不断一分为二,线段树上的一个节点 ,其左儿子为 (存储节点 i 的左半区间),右儿子为(存储节点i的右半区间)
举例:
对于数组,线段树,的左儿子,的右儿子;然后对于的左儿子,的右儿子;的左儿子 ,的右儿子
当我们要修改数组某点的值时,要修改所有包含的线段树节点的信息,询问数组上到的信息,可以通过递归不断在线段树上找合理的区间再处理答案。
BUT,这题要求做到区间修改,如果每次修改都一个一个遍历去改线段树那显然时间就寄了,所以就有了一个叫懒惰标记(lazy)的东西。
Lazy标记
延迟对线段树节点信息的修改。每次进行区间修改时,标记改区间被修改过,但不真正的去修改其子节点的信息。子节点的信息在第二次访问(更新或询问)到有lazy标记的节点时才更新。
int n, m;
int fa[5000100];
inline signed gf(int x) { return fa[x] == x ? x : fa[x] = gf(fa[x]); }
struct qujian {
	int l, r, len;
	ll S;//区间和
	ll lazy1 = 0;//加
	ll lazy2 = 1;//乘
};
qujian ary[4000010];
int a[400000];
void smallop(int p) {
	int l = p * 2;
	int r = p * 2 + 1;

	ary[l].S *= ary[p].lazy2;
	ary[r].S *= ary[p].lazy2;
	ary[l].S += (ll)ary[l].len * ary[p].lazy1;
	ary[r].S += (ll)ary[r].len * ary[p].lazy1;

	ary[l].lazy1 *= ary[p].lazy2;
	ary[l].lazy1 += ary[p].lazy1;
	ary[l].lazy2 *= ary[p].lazy2;

	ary[r].lazy1 *= ary[p].lazy2;
	ary[r].lazy1 += ary[p].lazy1;
	ary[r].lazy2 *= ary[p].lazy2;


	ary[l].S %= MOD;
	ary[r].S %= MOD;
	ary[l].lazy1 %= MOD;
	ary[l].lazy2 %= MOD;
	ary[r].lazy1 %= MOD;
	ary[r].lazy2 %= MOD;

	ary[p].lazy1 = 0;
	ary[p].lazy2 = 1;
}
void build(int L, int R, int p) {
	ary[p].l = L;
	ary[p].r = R;
	ary[p].len = R - L + 1;
	int mid = (L + R) / 2;
	if (L == R) {
		ary[p].S = (ll)a[L];
		return;
	}
	build(L, mid, p * 2);
	build(mid + 1, R, p * 2 + 1);
	ary[p].S = (ary[p * 2].S + ary[p * 2 + 1].S) % MOD;
}
void update(int l, int r, int c, int type, int p) {//要求改的区间 + 修改值 + 修改类型 + 当前节点
	int s = ary[p].l;
	int t = ary[p].r;
	int mid = (s + t) / 2;
	if (ary[p].l == 0)
		return;
	if (s >= l && t <= r) {//是子区间直接操作,标记lazy
		if (type == 2) {//区间加

			ary[p].S += (ll)ary[p].len * (ll)c;
			ary[p].S %= MOD;
			ary[p].lazy1 += (ll)c;
			ary[p].lazy1 %= MOD;
		}
		else if (type == 1) {//区间乘
			ary[p].S *= (ll)c;
			ary[p].S %= MOD;
			ary[p].lazy2 *= (ll)c;
			ary[p].lazy2 %= MOD;
			ary[p].lazy1 *= (ll)c;
			ary[p].lazy1 %= MOD;
		}
		return;
	}
	//更新子节点(因为lazy标记只能存一次)
	smallop(p);
	if (l <= mid)
		update(l, r, c, type, p * 2);
	if (r > mid)
		update(l, r, c, type, p * 2 + 1);
	ary[p].S = (ary[p * 2].S + ary[p * 2 + 1].S) % MOD;
}
ll Get(int l, int r, int p) {
	int s = ary[p].l;
	int t = ary[p].r;
	ll an = 0;
	if (s >= l && t <= r)
		return ary[p].S;
	smallop(p);
	if (l <= (s + t) / 2)
		an += Get(l, r, p * 2);
	an %= MOD;
	if (r >= (s + t) / 2 + 1)
		an += Get(l, r, p * 2 + 1);
	an %= MOD;
	return an;
}
void solve() {
	sii(n, m);
	for (int i = 1; i <= n; i++)
		si(a[i]);
	build(1, n, 1);
	for (int i = 1; i <= m; i++) {
		int op; si(op);
		if (op < 3) {
			int L, R, k;
			siii(L, R, k);
			update(L, R, k, op, 1);
		}
		else {
			int L, R;
			sii(L, R);
			printf("%lld\n", Get(L, R, 1));
		}
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
D. 辉夜大小姐希望完成她的愿望
题意:维护一个数据结构,支持:
- 插入数x
- 删除(一个)数x
- 查询x的排名
- 查询排名为x的数
- 求小于x,且最大的数(或没有)
- 求大于x,且最小的数(或没有)
Splay 维护二叉查找树(二叉平衡树)
二叉查找树满足性质:左子树的任意节点的值<根节点的值<右节点任意节点的值。其上每个节点需要维护:改节点的父亲、改节点的权值、改节点权值出现的次数、左右儿子的编号、以改节点为根的子树的大小。
普通的二叉查找树在不断的插入数据后,可能会退化成链,也就是左子树的大小于右子树的大小严重不搭。在这种左右不平衡的情况下二叉查找树的意义就没了。所以出现了用Splay做二叉平衡树。二叉平衡树与普通的查找树,区别在于二叉平衡树对于每一个节点x,其左右子树的深度差<=1。改性质通过不断将某节点旋转到根节点做到。
Splay 旋转操作
对于要旋转到根节点的x(其父为y),首先要判断x是y的左儿子还是右儿子,以确定旋转方向。另外,还需分几种具体情况。
搬了OI wiki上的图
-
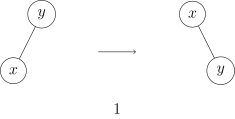
若y是根节点,直接旋x就行。如下图,将x改为是y的父亲,x的右儿子改为y。
这里如果x有右儿子的话,要把x的右儿子变成y的左儿子
-
若y不是根节点,需要判断一下x和y的所属儿子类型。设y的父亲是z,则我们需要判断x作为y的儿子类型和y作为z的儿子类型是否相同。
-
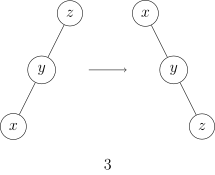
若相同,先旋转y再旋转x。下图是先将y右旋再将x右旋得到。
-
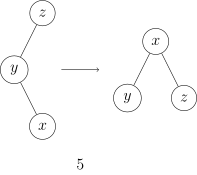
若不相同,连续旋转两次x。下图是先将x左旋再右旋得到。
-
接下来,对于插入操作,再插入数据后要把插入的那个点splay到根节点;对于删除操作,需要注意彻底删除某节点时要连接一波,不然树就断了;对于查询x的排名和查询排名为x的数,利用节点维护的子树size信息可以易得;对于查询x前驱,先把x插入树里,将x旋转到根节点,前驱就是根节点左子树里最靠右的那个点,查完后把x删除;后驱同理。
struct NODE {//根,它爸,它的权值,该权值出现次数,以它为根的树大小,左儿子sto,右儿子orz
	int fa, value, cut, size, l, r;
}node[200010];
int n,root, tot;//tot总节点个数
int ahhhh;
void update(int x) { node[x].size = node[node[x].l].size + node[node[x].r].size +node[x].cut; }//更新x的大小
int l_or_r(int x) { return node[node[x].fa].l == x; }//返回1则为左儿子,否则为右儿子
void kill(int x) { node[x].fa = node[x].value = node[x].cut = node[x].size = node[x].l = node[x].r = 0; }
void op1_insert(int k);
void op2_delect(int k);
int op3_askrank(int k);
void op4_asknum(int k);
void op5_beforemax(int k);
void op6_aftermin(int k);
void rotate(int x, int type) {//type为0->左旋,否则为右旋
	if (!type) {//左
		int father = node[x].fa, gfather = node[father].fa;
		node[father].r = node[x].l;
		if (node[x].l)
			node[node[x].l].fa = father;
		node[x].l = father;
		node[father].fa = x;
		node[x].fa = gfather;
		if (gfather) {
			if (node[gfather].r == father)
				node[gfather].r = x;
			else
				node[gfather].l = x;
		}
		update(father);
		update(x);
	}
	else {//右
		int father = node[x].fa, gfather = node[father].fa;
		node[father].l = node[x].r;//它爸的左儿子指向x的右儿子
		if (node[x].r)
			node[node[x].r].fa = father;//x右儿子的父亲指向x的爸
		node[x].r = father;//x的右儿子更改为(x的爸)
		node[father].fa = x;//(x的爸)的父亲指向x
		node[x].fa = gfather;
		if (gfather) {//换祖父的儿子
			if (node[gfather].r == father)
				node[gfather].r = x;
			else
				node[gfather].l = x;
		}
		update(father);//更新x原来的爸(现在是右儿子)的size
		update(x);//更新x的size
	}
}
void splay(int x) {
	for (int father = node[x].fa; father; father = node[x].fa) {
		if (node[father].fa) {//x的爸不是根节点
			int ff = l_or_r(father), xf = l_or_r(x);
			if (ff != xf) //类型不一,转x
				rotate(x, xf);
			else //类型一样,转father
				rotate(father, ff);
		}
		rotate(x, l_or_r(x));
	}
	root = x;
}
void cao(int x) {//把值为x的节点给splay到根处
	int now = root;
	while (1) {
		if (x > node[now].value)
			now = node[now].r;
		else if (x < node[now].value)
			now = node[now].l;
		else {
			splay(now);
			break;
		}
	}
}
void op1_insert(int k) {//插入
	if (!root) {//没根
		tot++;
		node[tot].value = k, node[tot].cut++;
		root = tot;
		update(root);
	}
	else {
		int now = root, father = 0;
		while (1) {
			if (node[now].value != k) {//权值不一样,开开开
				father = now;
				now = node[now].value < k ? node[now].r : node[now].l;
				if (!now) {//到底嘞
					node[++tot].value = k, node[tot].cut++, node[tot].fa = father;
					if (node[father].value < k)
						node[father].r = tot;
					else
						node[father].l = tot;
					update(tot), update(father);
					splay(tot);
					break;
				}
			}
			else {//权值一样直接操作
				node[now].cut++;
				update(now), update(father);
				splay(now);
				break;
			}
		}
	}
}
void op2_delect(int k) {//删除
	int now = root;
	op3_askrank(k);
	if (node[root].cut > 1) {
		node[root].cut--;
		update(root);
		return;
	}
	//删了就没根了
	if (!node[root].l && !node[root].r) {//彻底没了
		kill(root);
		root = 0;
		return;
	}
	if (!node[root].l) {//没左边,升右
		int tem = root;
		root = node[root].r;
		node[root].fa = 0;
		kill(tem);
		return;
	}
	else if (!node[root].r) {
		int tem = root;
		root = node[root].l;
		node[root].fa = 0;
		kill(tem);
		return;
	}
	int rot = root, tem = node[root].l;
	if (tem) {
		while (node[tem].r)
			tem = node[tem].r;
		splay(tem);
	}
	node[node[rot].r].fa = tem;
	node[tem].r = node[rot].r;
	kill(rot);
	update(root);
}
int op3_askrank(int k) {//查询排名
	int now = root, sum = 0;
	while (now) {
		if ( k < node[now].value)
			now = node[now].l;
		else if(k>node[now].value){
			sum += node[node[now].l].size + node[now].cut;
			now = node[now].r;
		}
		else {
			sum += node[node[now].l].size;
			splay(now);
			return sum + 1;
		}
	}
	return ahhhh + 1;
}
void op4_asknum(int k) {//查询数
	int now = root;
	while (1) {
		if (node[now].l && k <= node[node[now].l].size)
			now = node[now].l;
		else {
			k -= node[now].cut + node[node[now].l].size;
			if (k <= 0) {
				splay(now);
				printf("%d\n", node[now].value);
				return;
			}
			now = node[now].r;
		}
	}
}
void op5_beforemax(int k) {//查询前驱
	op1_insert(k);
	int now = node[root].l;
	if (!now)
		puts("NOT FOUND");
	else {
		while (node[now].r)
			now = node[now].r;
		splay(now);
		printf("%d\n", node[now].value);
	}
	op2_delect(k);
}
void op6_aftermin(int k) {//查询后驱
	op1_insert(k);
	int now = node[root].r;
	if (!now)
		puts("NOT FOUND");
	else {
		while (node[now].l)
			now = node[now].l;
		splay(now);
		printf("%d\n", node[now].value);
	}
	op2_delect(k);
}
void solve() {
	si(n);
	for (int i = 1; i <= n; i++) {
		int op,k ;
		sii(op,k);
		switch (op) {
		case 1:
			ahhhh++;
			op1_insert(k);
			break;
		case 2:
			ahhhh--;
			op2_delect(k);
			break;
		case 3:
			printf("%d\n", op3_askrank(k));
			break;
		case 4:
			op4_asknum(k);
			break;
		case 5:
			op5_beforemax(k);
			break;
		case 6:
			op6_aftermin(k);
			break;
		default:
			break;
		}
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
E. 啥b二次元
题意:首先有n个数,每个数的值为**。同时这n个数是一个接一个到来的,即每个数有到达时间time**,每当一个数到达时,求当前序列里满足的(i,j)对数
三维 CDQ 分治 + 树状数组
-
CDQ 的处理思想:
对于询问区间上的点对,直接处理和的点对;对于其他点对,我们继续去二分区间来找满足上面那个表达式的点对。
-
树状数组的结构:
OI wiki的图 树状数组 - OI Wiki (oi-wiki.org)
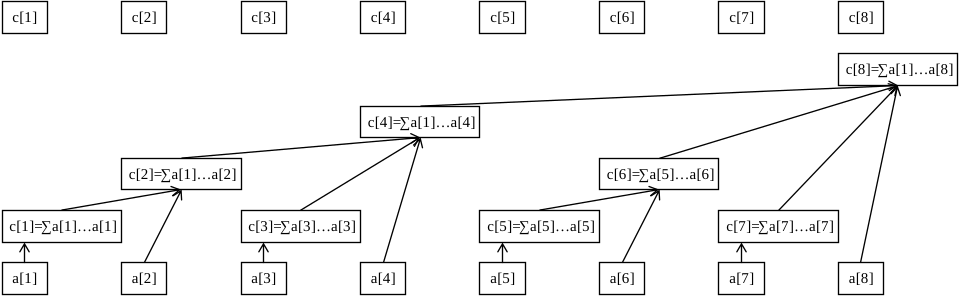
有下列性质:
- 包含于
本题里虽然数字有到达时间,可以把数字的到达时间存起来离线操作。直接按time从小到大排序,这样在后续处理的时候可以直接保证右区间的time是大于左区间的,也就是减去了一个维度。
对于上,处理满足和的(i,j)点对:
- 将和区间按排序,这样可以整双指针
- 顺序遍历到的,对于每一个i,查找合理的j(j从L到mid),使得,将j对应的插入树状数组。当时(不合理的)停止查找,则树状数组里数的总数减去的前缀和就是ans[i](满足)。之后继续查下一个i(j不做初始化,继续++)
- i从L遍历到j,把线段树清空,此时处理完了的情况
- 的情况完全类似,但是逆序遍历i和j
int n, m;
int block[N], a[N],mp[N];
ll ans[N];
//block[i] = a[i - 2^k + 1] + a[i - 2^k + 2] + ... + a[i]
//a[i] 包含于 block[i],block[i + 2^k],block[(i + 2^k) + 2^k]
struct  C{
	int power, pos, geth;//战力值,在仓库的位置,抽到的顺序
}card[N];
int lowbit(int x) { return x & -x; }//取2^k,其中的2^k为 i & -i
void add(int x, int k) { while (x <= n) block[x] = block[x] + k, x += lowbit(x); }//在a[x]上加 k
ll getsum(int x) { ll tem = 0; while (x > 0) tem += (ll)block[x], x -= lowbit(x); return tem; }//求前x个的和
bool cmp(C a, C b) { return a.geth < b.geth; }
bool cmp2(C a, C b) { return a.pos < b.pos; }
ll sumsum;//记录树状数组大小
void CDQ(int l, int r) {
	if (l == r)return;//i=j不考虑
	int mid = (l + r) >> 1;
	CDQ(l, mid), CDQ(mid + 1, r);
	sort(card + l, card + mid + 1, cmp2), sort(card + mid + 1, card + r + 1, cmp2);//左右区间按pos排序,此时右区间的geth是一定>左区间的geth,即左区间先抽到的,那我们外层遍历i时,内层j的geth必是满足条件的
	int i, j;//   i j 双指针,因为排序了pos所以可以这样做,要注意遍历的顺、逆顺序 (orz orz orz 绝绝子)
	//pos[j]<pos[i]&&power[j]>power[i]
	for (i = mid + 1, j = l; i <= r; i++) {//顺序遍历
		for (; j <= mid; j++)
			if (card[j].pos < card[i].pos)//只要满足pos条件就把对应的power加入树状数组(数量+1),之后再统计前缀和就是处理了power条件
				add(card[j].power, 1), sumsum++;
			else
				break;
		ans[card[i].geth] += sumsum - getsum(card[i].power);//统计 power > power[i]
	}
	for (i = l; i < j; i++)add(card[i].power, -1), sumsum--;//清空树状数组,接下来还要处理左区间
	//pos[j]>pos[i]&&power[j]<power[i]
	for (i = r, j = mid; i > mid; i--) {//逆序遍历
		for (; j >= l; j--)
			if (card[j].pos > card[i].pos)
				add(card[j].power, 1);
			else
				break;
		ans[card[i].geth] += getsum(card[i].power - 1);//统计power < power[i]
	}
	for (i = mid; i > j; i--)add(card[i].power, -1);
}
void solve() {
	si(n);
	for (int i = 1; i <= n; i++) {
		int tem; si(tem);
		card[i].power = tem, card[i].pos = i;
		mp[tem] = i;
	}
	for (int i = 1; i <= n; i++) {
		int tem; si(tem);
		card[mp[tem]].geth = i;
	}
	sort(card + 1, card + n + 1, cmp);//先对获取时间排序来减少一个维度
	CDQ(1, n);
	for (int i = 1; i <= n; i++)ans[i] += ans[i - 1];//CDQ里只是处理了单点的答案,要合起来
	for (int i = 1; i <= n; i++) printf("%lld\n", ans[i]);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
I. Namesolo 拜师
题意:给定一个有n个点的无向图,有两个操作:
- 添加一条连接a,b的边
- 询问a,b是否在同一连通块
并查集及其优化
普通并查集:
int getfa(int x){ return fa[x] == x ? x : getfa(fa[x]); }
直接去递归查询,但是重复很多无用的操作,效率低。
优化1:路径压缩
int getfa(int x) { return fa[x] == x ? x : fa[x] = getfa(fa[x]); }
查询路径上的每个节点都直接连到根上,就是边跑边连
优化2:启发式合并(按秩合并)
OI wiki: 具体来说,如果我们将一棵点数与深度都较小的集合树连接到一棵更大的集合树下,显然相比于另一种连接方案,接下来执行查找操作的用时更小(也会带来更优的最坏时间复杂度)。 并查集 - OI Wiki (oi-wiki.org)
if (S[x] <= S[y]) //S[i]是子树i的大小
	fa[x] = y,S[y] += S[x];//把小的那个连到大的里去
else
	fa[y] = x,S[x] += S[y];
int n, m, r;
int fa[5000100];
inline signed gf(int x) { return fa[x] == x ? x : fa[x] = gf(fa[x]); }
//inline signed gf(int x) { return fa[x] == x ? x : gf(fa[x]); }
vector<ll>S(5000100, 1);
int mer[5000100];
ll an = 0;

#define getchar() (frS==frT&&(frT=(frS=frBB)+fread(frBB,1,1<<15,stdin),frS==frT)?EOF:*frS++)
char frBB[1 << 15], * frS = frBB, * frT = frBB;
template<typename T>
inline void read(T& x) {
	x = 0; char c = getchar();
	while (!isdigit(c))c = getchar();
	while (isdigit(c)) { x = x * 10 + c - '0'; c = getchar(); }
}

void solve() {
	sii(n, m);
	int cut = 0;
	for (int i = 1; i <= n; i++)
		fa[i] = i;
	for (int i = 1; i <= m; i++) {
		int op, u, v;
		read(op) ;
		read(u);
		read(v);
		int x, y;
		x = gf(u); y = gf(v);
		if (op == 1) {
			if (x != y) {
				if (S[x] <= S[y]) {
					fa[x] = y;
					S[y] += S[x];
				}
				else {
					fa[y] = x;
					S[x] += S[y];
				}
			}
		}
		else {
			if (x == y) {
				an *= 2;
				an += 1;
				an %= MOD;
			}
			else {
				an *= 2;
				an %= MOD;
			}
		}
	}
	printf("%lld", an);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
J. 魔法商店
题意:有n件商品,每个商品有价值,同时有n张面值分别为的纸币。每个商品只能用一张纸币购买且不找零。k次法术,每次法术可任意改变一张纸币的面值。求支付的最小钱面值和(或买不完)。
分析:
-
首先,对于面值与商品价值相等的纸币,直接拿去买是一定不会吃亏的:若面值过大,可能会过剩(虽然可以用法术减少面值,但是消耗法术不值当);面值过小,会消耗法术。因此先将纸币面值和商品价值相等的纸币和商品挑出来加到ans里。
-
对于剩下的商品,先不管法术,考虑用与商品价值最接近且大于的那张纸币去买。但这里就会出现一个细节问题,是按商品价值从小到大去找钱还是从大到小?假设法术的次数不足以让所有纸币都变成恰好等于商品价值,那么用法术把小钱变大显然是变的越小越好,因为这样才可以保证支付的面值和最小。
- 若是按从小到大遍历:先把便宜的几件商品用(过剩的)纸币买了,对于买不起的商品用法术改变面值去买,此时是拿非常小的钱去变非常贵的商品,简直浪费前面那几张大钱
- 若是按从大到小遍历:贵的钱拿大的面值去买,啥也买不起的小钱用法术变成对应的小面额买便宜商品,与上面那种情况相比,钱浪费的更少,是更优的选择
综上,按商品价值从大到小去找钱,拿与商品价值最接近且大于的那张纸币去买(multiset里的lower_bound()),拿商品价值更新ans,同时记录一下钱币过剩的面值。若买不起就增加一次法术使用次数,法术不够用了就寄了输出NIE。
-
现在到了最终阶段:处理过剩的面值(假如法术还有剩余),按过剩面值从大到小,ans减去前k'个(k'是法术剩余量)过剩面值。结束。
int n, m, k;
multiset<ll>money, goods;
multiset<ll, greater<ll> >duo, mag;//降序
ll an, an_le;
int cut;
void solve() {
	sii(n, k);
	for (int i = 1; i <= n; i++) {
		ll tem; si(tem);
		money.emplace(tem);
	}
	for (int i = 1; i <= n; i++) {
		ll tem; si(tem);
		goods.emplace(tem);
	}
	auto tem = money.begin();
	for (auto it : goods) {
		if ((tem = money.find(it)) != money.end()) {//找等于的钱,一一匹配
			an += *tem;
			money.erase(tem);
		}
		else
			duo.emplace(it);
	}
	if (!money.empty()) {//存在没有一一匹配的
		for (auto it : duo)
			if ((tem = money.lower_bound(it)) != money.end()) {
				an += it;
				mag.emplace(*tem - it);//mag存过剩的钱
				money.erase(tem);
			}
			else {
				an_le += it;//记录一下买不起的
				cut++;//记录一下买不起的数量
			}
	}
	int k_left = k-cut;
	if (k_left<0) {
		printf("NIE");
		return;
	}
	an += an_le;
	if (!mag.empty()) {
		for (auto it : mag) {
			if (k_left <= 0)
				an += (ll)it;
			k_left--;
		}
	}
	printf("%lld\n", an);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
K. 云海蝴蝶螺
题意:维护一个二维数据结构,支持单点修改和区间查询
二维线段树
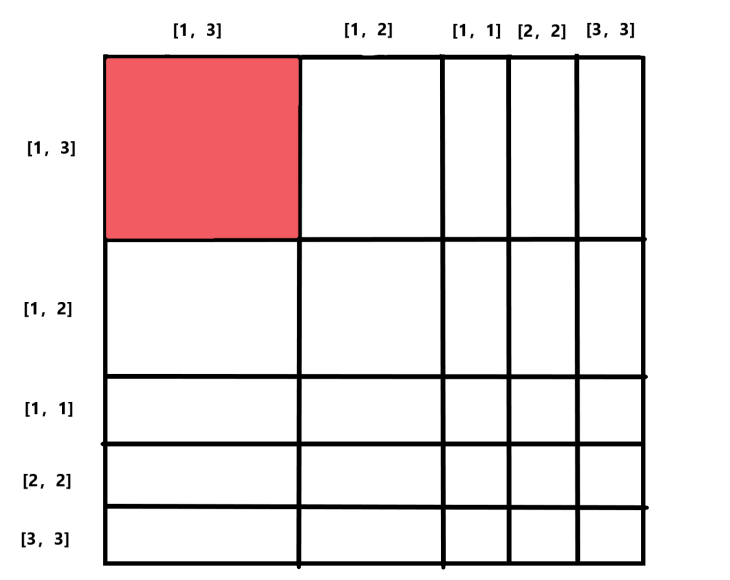
建树:先在第一维建线段树,在一维线段树的每个节点上再建一个线段树,即第二维。
我们先横向跑第一维,找到叶节点后向下跑第二维,最后逆着更新叶节点外层的。
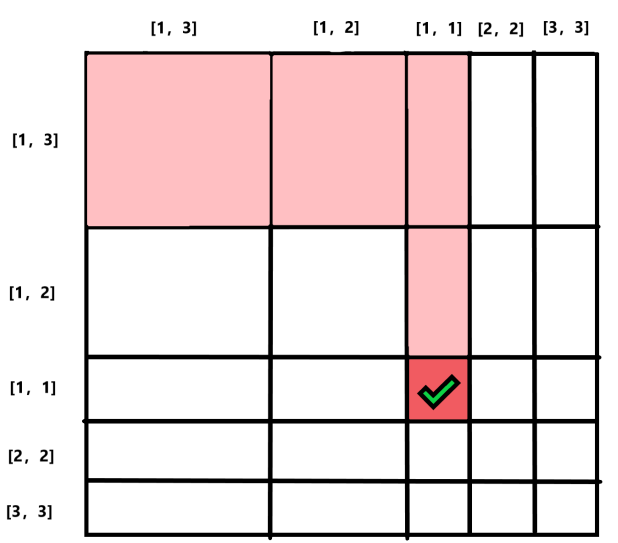
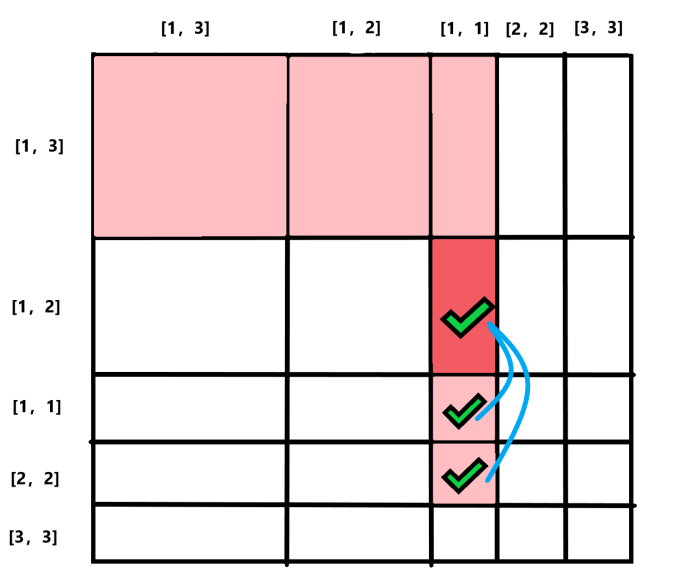
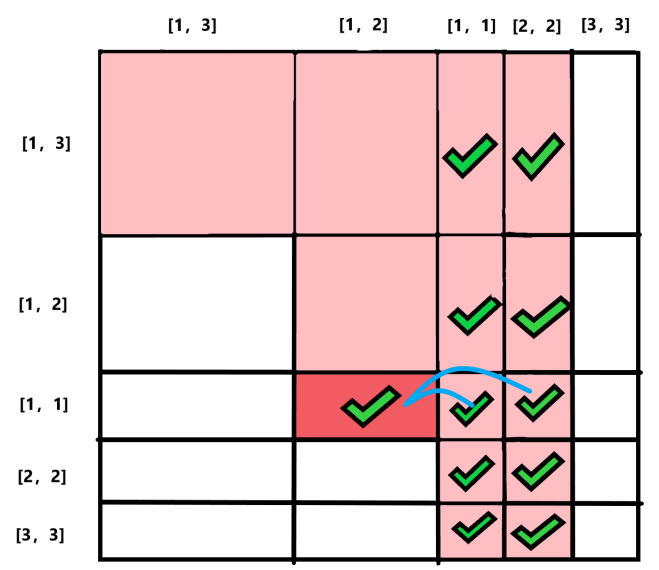
如图是一个3*3矩阵建立的二维线段树,其中深红色为当前节点,浅红色为待确定值的节点,白色是还没跑过的节点。
-
第一维,第二维皆为叶节点:直接取原矩阵的值,如下图的([1,1],[1,1]),其就是原矩阵的(1,1)。
-
继续跑,非叶节点的值取其两个儿子(二维方向)的值,注意此时第一维还是叶节点。如下图([1,1],[1,2])取其二维方向的两个儿子([1,1],[1,1])和([1,1],[2,2])。
- 对于第一维非叶节点的情况,更新第二维的叶节点时用其一维方向的两个儿子的值,如下图([1,2],[1,1])第一维不是叶节点,取其横向两个儿子的值。
- 继续跑就建完啦:blush:
单点修改:需要注意的细节是,每更新一个(叶节点,叶节点),往回退出函数的时候要沿路把所有的关联节点都更新一下第二维,保证更新完全。
区间查询:和一维线段树同理。
int n, m;
int fa[5000100];
inline signed gf(int x) { return fa[x] == x ? x : fa[x] = gf(fa[x]); }
int mp[505][505];
int M[4010][4010];
int Mm[4010][4010];
int ux, uy, uk;//修改的三个参数
int aM, am;
int x1, y11, x2, y2;//查询的四个参数
void buildy(int posx, int posy, int x, int y, int l, int r);
void updatey(int posx, int posy, int l, int r, int k);
void updatex(int posx, int l, int r) {
	if (l != r) {//更新从叶节点开始,找叶节点
		int mid = (l + r) / 2;
		if (ux > mid)
			updatex(posx * 2 + 1, mid + 1, r);
		else
			updatex(posx * 2, l, mid);
		updatey(posx, 1, 1, n, -1);//它的第二维也要更新一波,直接跑一遍就行
		return;
	}
	//找到叶节点了
	updatey(posx, 1, 1, n, uk);
}
void updatey( int posx, int posy, int l,int r,int k) {
	if (l != r) {//不是叶节点,上下取
		int mid = (l + r) / 2;
		if (uy <= mid)
			updatey(posx, posy * 2, l, mid, k);
		else
			updatey(posx, posy * 2 + 1, mid + 1, r, k);
		M[posx][posy] = max(M[posx][posy * 2], M[posx][posy*2+1]);
		Mm[posx][posy] = min(Mm[posx][posy * 2], Mm[posx][posy * 2 + 1]);
		return;
	}
	if (k != -1) {
		M[posx][posy] = k;
		Mm[posx][posy] = k;
	}
	else {
		M[posx][posy] = max(M[posx * 2][posy], M[posx * 2 + 1][posy]);
		Mm[posx][posy] = min(Mm[posx * 2][posy], Mm[posx * 2 + 1][posy]);
	}
}
void findy(int l, int r, int posx, int posy);
void findx(int l, int r, int posx) {
	if (l >= x1 && r <= x2)//一维到达范围,查对应二维
		findy(1, n, posx, 1);
	else {//继续找
		int mid = (l + r) / 2;
		if (x1 <= mid)
			findx(l, mid, posx * 2);
		if (x2 > mid)
			findx(mid + 1, r, posx * 2 + 1);
	}
}
void findy(int l,int r,int posx, int posy) {
	if (l >= y11 && r <= y2) {
		aM = max(aM, M[posx][posy]);
		am = min(am, Mm[posx][posy]);
	}
	else  {//继续找
		int mid = (l + r) / 2;
		if (y11 <= mid)
			findy(l, mid, posx, posy * 2);
		if (y2 > mid)
			findy(mid + 1, r, posx, posy * 2 + 1);
	}
}
void buildx(int posx, int l, int r) {
	if (l != r) {//第一维的线段树,一直找到叶节点,从叶节点倒着建
		int mid = (l + r) / 2;
		buildx(posx * 2, l, mid);
		buildx(posx * 2 + 1, mid + 1, r);
	}
	buildy(posx, 1, l, r, 1, n);
}
void buildy(int posx, int posy, int x, int y, int l, int r) {//第一维节点的x + 第二维线段树的坐标(y) + 处理第二维时对应第一维的区间左右坐标 + 第二维的l和r
	if (l != r) {
		int mid = (l + r) / 2;
		buildy(posx, posy * 2, x, y, l, mid);
		buildy(posx, posy * 2 + 1, x, y, mid + 1, r);
		M[posx][posy] = max(M[posx][posy * 2], M[posx][posy * 2 + 1]);//取第二维左右儿子的最大值
		Mm[posx][posy] = min(Mm[posx][posy * 2], Mm[posx][posy * 2 + 1]);
		return;
	}
	//l==r说明第二维到叶节点了,更新当前posx的最大值
	if (x == y) {//如果对应的是第一维的叶节点x==y,那显然这个区间的就是个点,最大值确定
		M[posx][posy] = mp[x][l];
		Mm[posx][posy] = mp[x][l];
	}
	else {//第二维到叶节点了,但第一维不是,所以找第一维左右儿子的最小值
		M[posx][posy] = max(M[posx * 2][posy], M[posx * 2 + 1][posy]);
		Mm[posx][posy] = min(Mm[posx * 2][posy], Mm[posx * 2 + 1][posy]);
	}
}
void solve() {
	si(n);
	for (int i = 1; i <= n; i++)
		for (int j = 1; j <= n; j++)
			si(mp[i][j]);
	buildx(1, 1, n);
	si(m);
	while (m--) {
		int op; si(op);
		if (op == 1) {//修改
			siii(ux, uy, uk);
			updatex(1, 1, n);
		}
		else {//查询
			aM = 0;
			am = 1e9;
			sii(x1, y11); sii(x2, y2);
			findx(1, n, 1);
			printf("%d %d\n", aM, am);
		}
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
L. gamers的众数
题意:给定一个长为n的数列,n次询问[L,R]内的最小众数。
分块思想
算法流程:将数据分成块(长度能达到最优),预先处理每一块内的数据。对[L,R]上的询问可以分成两类:1.完全占满块的部分 2.多出来的,没有占满块的部分。对于第一类,因为已经预处理了所以就直接拿来用,对于第二类采用暴力处理反正也不多
细节处理:
- 考虑到数组里的数据范围是到,这么大的数据想开数组做记录是开不动的,但是发现n的范围是1到,也就是说不同类的数字最多,开数组完全做的到,于是就有了数据离散化
-
数据离散化:
对于数据大小很离谱的数组a,先将a数组复制到b数组,对b数组排序,用a[i]在b中的下标来代替a[i],此时a数组的数据大小就合理了且不影响处理。
- [L,R]区间内的众数,只有两种情况,要么是已处理块上的众数,要么是两边多出来的的区间上的某个数。那么就又出现了一个问题:如何知道一个数x在[L,R]区间上的出现次数?
-
查询x在区间[L,R]上的出现次数:
-
前缀和:和A题一样,要预处理,对于本题的数据范围太离谱。
-
指针操作:开一个vector<int> C[N],其中C[i]里记录的是i在原数组里依次出现的下标。那么x在[L,R]的出现次数就是x在该区间第一次出现的位置在C[x]里对应的位置(用指针)减去在改区间里最后一次出现的位置在C[x]里对应的位置。
int gettimes(int x, int l, int r) { return upper_bound(C[x].begin(), C[x].end(), r) - lower_bound(C[x].begin(), C[x].end(), l); }
-
回滚莫队
莫队:优雅的暴力,离线操作,先对询问的区间进行排序后再依次处理。
对于本题,当询问区间变大时很容易就能判断众数是否改变,但缩小区间就非常困难。因此,我们控制莫队的区间只变大不变小。对于莫队的左右指针,左指针控制在分块的右端点+1,这样在该区块里左指针一定是往区间增大的方向走,走完之后进行回滚操作,即把左指针再滚回右端点+1的位置。右指针因为排序的缘故能保证一直增就无所谓了。
int n, len,  M_times, lit, rit;//M_num记录数字,M_times记录数量,lit左游标,rit右游标
int M_num;
int a[100010], a_c[100010];//克隆数组
int ans[100010], cut[100010];
int zhong[5010][5010];
unordered_map<int, int> LS;//离散map
vector<int> cx[100010];//出现的次序
int get_th(int x) { return (x - 1) / len + 1; }//获得所属的块
int gettimes(int x, int l, int r) { return upper_bound(cx[x].begin(), cx[x].end(), r) - lower_bound(cx[x].begin(), cx[x].end(), l); }
void update(int x) {//加
	if (cut[x] > M_times)
		M_times = cut[x], M_num = x;
	else if (cut[x] == M_times)
		M_num = min(M_num, x);
}
void update2(int x,int nn) {
	if (x > M_times)
		M_times = x, M_num = nn;
	else if (x == M_times)
		M_num = min(M_num, nn);
}
void lisanhua() {//离散化
	sort(a_c + 1, a_c + 1 + n);
	for (int i = 1; i <= n; i++)
		LS[a_c[i]] = i;
	for (int i = 1; i <= n; i++)
		a[i] = LS[a[i]];
	for (int i = 1; i <= n; i++)
		cx[a[i]].push_back(i);
}
void QAQ(int N) {
	for (int i_an = 1; i_an <= N; i_an++) {
		int l, r; sii(l, r);
		int lth = get_th(l), rth = get_th(r);
		M_times = -1;
		if (lth == rth) {
			memset(cut, 0, sizeof(cut));
			for (int i = l; i <= r; i++)
				cut[a[i]]++, update(a[i]);
		}
		else {
			int lm = lth * len, rm = (rth -1)* len+1, tem;
			for (int i = l; i <= lm; i++)
				tem = gettimes(a[i], l, r), update2(tem, a[i]);
			for (int i = rm; i <= r; i++)
				tem = gettimes(a[i], l, r), update2(tem, a[i]);
			if (lth + 1 <= rth - 1)
				tem = gettimes(zhong[lth + 1][rth - 1], l, r), update2(tem, zhong[lth + 1][rth - 1]);
		}
		printf("%d\n", a_c[M_num]);
	}
}
void solve() {
	si(n);
	for (int i = 1; i <= n; i++)
		si(a[i]), a_c[i] = a[i];
	lisanhua();
	len = (int)sqrt((double)n);//分块区间长度
	int nb = n / len;
	for (int i = 1; i <= nb; i++, memset(cut, 0, sizeof(cut))) {
		M_times = -1;
		for (int j = i; j <= nb; j++) {
			int tem = j * len;
			for (int k = (j - 1) * len + 1; k <= tem; k++)
				cut[a[k]]++, update(a[k]);
			zhong[i][j] = M_num;
		}
	}
	QAQ(n);
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}
Z. 卷卷人的计划表
题意:维护一个数据结构,支持在低第pos个数前插入一个数,同时又支持查询第pos个数是什么
块状链表
思想:将长度为n的数组分成个节点,每个节点的大小是。支持的操作:分裂,插入,查找。
-
分裂:
当前节点大小超过,要分裂成两个节点
操作方法:
- 新建一个节点,将被分裂节点后数据放到新节点,同时被分裂节点也要删掉这些数据。最后将新节点插入被分裂节点后面。
-
插入:
找到对应节点的对应位置后直接添加。
-
查找:
利用节点的size快速跳到对应节点,接着在节点内继续找。
STL扩展rope
就是个弄好的块状链表,有char和int两种
#include<ext/rope>
using namespace __gnu_cxx;
rope<int> x;
基础操作:
x.length() 返回x的大小
x.push_back(s) 在末尾添加s
x.insert(pos,s) 在pos位置插入s
x.erase(pos,x) 从pos位置开始删除x个
x.replace(pos,s) 将位置为pos的元素换成s
x.substr(pos,x) 从pos位置开始提取x个元素
x.copy(pos,x,s) 将从pos位置开始x个元素提取到s中
x.at(x)/[x]访问第x个元素
int n, m;
rope<int> STL_YES;
void solve() {
	sii(n, m);
	for (int i = 1; i <= n; i++) {
		int tem; si(tem);
		STL_YES.append(tem);
	}
	while (m--) {
		int op; si(op);
		if (op == 1) {
			int k, pos; sii(k, pos);
			STL_YES.insert(pos-1,k);
		}
		else {
			int pos; si(pos);
			printf("%d\n", STL_YES[pos - 1]);
		}
	}
}
int main() {
	int t;
	/*si(t);
	while (t--)*/
	solve();
	return 0;
}